
タグ: システムダウン / システム障害(用語)
システムダウン / システム障害に関する記事一覧
オンラインワークスペースのNotionに一時DNS原因の障害発生
2020年に20億ドル以上(約2100億円)の評価を受けたオンラインワークスペースのスタートアップNotionは、DNS(ドメインネームサーバー)障害の後にサービスが一時停止した。なお公式サイトによると、障害が発生した当日のうちに問題は解決している。 関連記事:職場の生産性プラットフォーム運営のNotionが約54億円調達 共同オンラインオフィスとドキュメントサービスを提供するNotionは東部標準時2月12日金曜日午前9時の時点でサービスが停止し、利用者は誰もクラウドに保存されたデータにアクセスできなかった。 後に削除されたツイート…続きを読む
アップルのネットサービスで広範囲の障害発生中、iCloudなどが機能停止
米国時間2月3日朝、Apple(アップル)が確認したところによると、いくつかのAppleサービスで障害や機能停止が発生しているという。これらの障害はApple Music、Apple Music Radio、Apple Books、iOSデバイスとMacの両方にまたがるApp Storeプラットフォームなど、多くの消費者向けサービスに影響を与えている。 一部ユーザーの間では、サービスへの接続障害が生じている。たとえば米国時間3日朝、ユーザーがApple Musicを通じて音楽をストリーミングしたり、iTunesを利用したりする際に問題…続きを読む
小さな企業でも突然のシステム障害に迅速に対処できるようにするStackPulseが29億円調達
突然システムが停止すれば、担当チームは原因の追求と復旧方法の解明のために大混乱に陥るのは必至だ。そんなとき開発者の危機管理を効率的な方法で助けてくれる新しいスタートアップStackPulse(スタックパルス)が、米国時間1月19日、2800万ドル(約29億円)の資金調達を発表し、ステルスモードから姿を現した。 この投資は、実際には未公表だった前回の800万ドル(約8億3000万円)のシード投資ラウンドと、新規の2000万ドル(約20億7500万円)のシリーズA投資ラウンドの2つで構成されている。今回のラウンドはGGVが主導した。Bes…続きを読む
Slackで日本時間1月5日午前0時すぎに障害(現在は復旧)
Slackは米国時間1月4日の朝(日本時間1月5日未明)、仕事への復帰を可能な限り混沌かつ非生産的なものにすることで、休暇から仕事に復帰する社会人のために最善を尽くした。 ダウンタイムがいつから始まったのかは不明だが、米TechCrunchのスタッフの間で問題が起きたのは午前10時過ぎだった。Slack自身も東部時間午前10時14分(日本時間午前0時14分)に問題があったことを投稿している。 ダウンタイムの問題は2019年半ばに株式公開され、2020年末にSalesforceに売却すると発表したSlackにとって、目新しいものではない…続きを読む
Gmailが再びダウン(現在は復旧)
米国時間12月14朝(日本時間12月14日夜)のように完全にダウンしたわけではないようだが、Gmailユーザーから、メールサービスに重大な問題があるという報告を数多く届いている。 Gmailが特に遅いと報告しているユーザーもいれば、常にエラーメッセージが表示されていると報告するユーザーもいる。一方、TechCrunchのあるライターは、彼がGmailアカウントに送っていたメールがすぐ跳ね返ってきて、Gmailのサーバーが「550-5.1 .1あなたがアクセスしようとしたメールアカウントは存在しません」というエラーで応答したことに気付い…続きを読む
Googleサービスがクラッシュする中、マイクロソフトのOutlookも断続的にダウン
米国時間12月14日のGoogle(グーグル)のサービス停止ほどの規模ではないが、Microsoft(マイクロソフト)のメールサービス、Outlookでも問題が発生していることがわかった。 読者からの報告によると、マイクロソフトのさまざまなOfficeサービスのサイトステータスの最新情報によると、一部のOutlookユーザーは、Active Directoryインフラストラクチャの不具合のために、Outlook.comにサインインして電子メールを使用することができない可能性がある。 マイクロソフトは、今回のサービス停止がヨーロッパのユ…続きを読む
Gmail、YouTube、Googleドライブなどが日本を含む複数国で一時ダウン、現在ほぼ復帰
【更新】いろいろなサービスが復活し始めているようだが、いくつか問題が残っている(たとえばGmailのアドレスバーが正しく動作しない)。Google(グーグル)にコメントを求めたが、返答は得られなかった。数分前、グーグルはGoogle CloudのTwitterアカウントに「内部記憶容量割り当て問題」のために認証システムが停止したとの理由を投稿をした。 本日、太平洋時間の午前3時47分、グーグルは内部ストレージ容量の問題により、認証システムが約45分間停止しました。ユーザーのログインを必要とするサービスで、この期間に高いエラー率が発生し…続きを読む

FacebookとInstagramがダウン(現在は復旧)
日本時間の8月4日夜、FacebookやInstagramのユーザーから「トラブルが起きている」という報告が相次いだ。日本時間8月5日午前4時45分にFacebookは「問題は解決した」と発表 。 FacebookはTechCrunchに次のようなコメントを寄せた。 今日、ネットワーク上の問題によって一部のユーザーのFacebook系サービスへのアクセスに障害が出た。我々は問題を解決しており、運用は完全に正常な状態に戻っている。ご不便をおかけしたことにお詫びする。 モバイルアプリがロードしないユーザーが多数出ており、Twitterを利…続きを読む
Google Cloudが一時ダウン、多数のサービスに影響
Google Cloud Platformに障害が発生し、Snap、Discordを始めとするクラウド利用者や、Gmail、Nestなど数多くのGoogleサービスに影響を与えた。最初に問題を報告したのは米国東海岸のユーザーだったが、障害監視サイトの DownDetectorによると、ほかにも多くの地域が影響を受けている。 Google Cloud outage appears to be outside of North America too, according to https://t.co/wFrvM3zdVo — repo…続きを読む
Facebookのダウンの原因は社内のサーバー設定エラーと発表
Facebookは昨日のサービスのダウンに関するレポートを発表した。この障害は異例に広範囲かつ長時間にわたり、Facebook本体だけでなく、Instagram、Messengerも正常に作動しなくなった。 専門家の間では原因をルート・リークに求める意見が多かったが、Facebookによれば、サーバー設定エラーが問題を引き起こしたものという。 Yesterday, as a result of a server configuration change, many people had trouble accessing our ap…続きを読む
FacebookとInstagramの世界的なダウンはBGPのルート・リークが原因か
昨夜から世界的にFacebookファミリーのサービスで不調が続いている。セキュリティ企業の一部は、大きな原因はBGP(ボーダー・ゲートウェイ・プロトコル)の「ルート・リーク」によるものだろうと推測している。 トラフィックを最適な経路で送受信するためのルーティングはこのBGPに大きく依存している。BGPはルーティング・ポリシーを共有する大規模なネットワーク(AS、自律システム)間でのトラフィックの経路を規定するプロトコルだ。これには不正または悪意があると認定されたアドレスが送信されないようにする機能がある。しかしときおりミスが起きるのは…続きを読む
Gmail、Googleドライブで全世界的な障害が発生中(2019年3月13日午後12時現在)
日本時間3月13日お昼前ごろより、メールサービスGmailや、クラウドストレージGoogle DriveといったGoogleのサービスに障害が発生している模様です。主な症状はGmailの「送受信がまったくできない」といったお手上げなものから、「テキストや画像を添付したメールの送受信はできるもののその他の添付ファイルがあると送信できない」、「メールを書いている途中にエラーになる」などさまざまです。 GoogleがG Stuiteサービスのパフォーマンス状況として提供している「G Suite ステータス ダッシュボード」によれば、障害が発…続きを読む
BioWare期待のゲーム「Anthem」はプレイヤー集中でサーバーダウン
Destinyや、その他のオンラインシューティングの大作たちに対するBioWareからの回答であるAnthemに、ゲームの世界は沸き返っている。だがこの飛行メカゲームのために用意された限定プレビューの週末には、大変な苦労が待っていた。もちろん、イベントを盛り上げる多少のドタバタなしには、今どきのゲーム発表とは言えないが、今回のものは実際に少々困りものだった。 40ギガバイトのデモは、プレスやその他の”VIP”はもちろん、ゲームを予約注文した人たちも遊ぶことができるようになっていた。昨年のE3で発表されたこのゲームは、仲間と共に戦闘と探…続きを読む
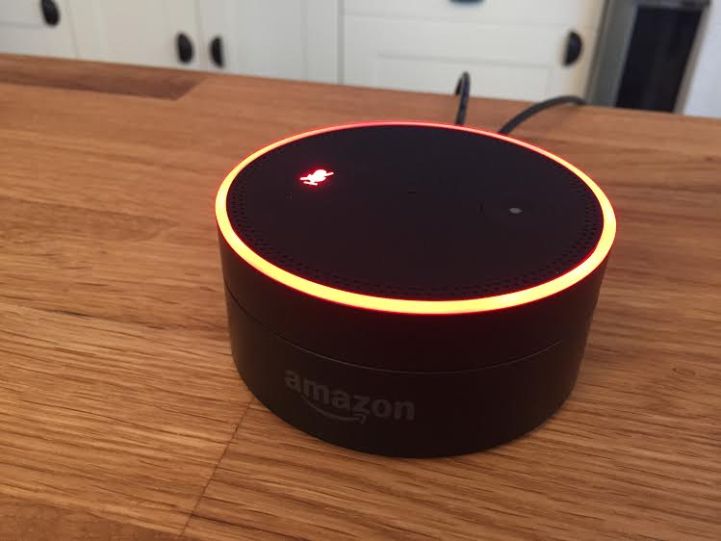
Alexa、文字通り「声をなくす」
今日(米国時間3/2)午前、Amazonのスマートアシスタント、Alexaがダウンしたらしい。レスポンスが悪くなったり、完全に接続が切れたという報告が届いている。 Amazonは消費者向けサービスの状態ページは提供していないが、ここ数時間Down DetectorがAlexa関連の苦情が急増したことを示している。 ちなみにAlexaの反応は、“I’m not sure what went wrong” や “sorry, something went wrong”、大きなチャイム音に続く “sorry, your echo dot l…続きを読む
Amazon S3が停止した日―アナリストは冗長性の重要性を指摘
昨日(米国時間2/28)、Amazonのバージニア州北部データセンターに障害が発生し、 AWS S3クラウド・ストレージ・サービスが4時間近くダウンしたというニュースはご存知のことと思う。その結果、有名なウェブサイトやサービスが停止し、大きな混乱が起きた。 念のため断っておけば、今朝、Amazonのダッシュボードはすべて正常に動作中であることを示している。 影響を被ったサイトやサービスにとっては大事件だったものの、Amazon S3は長年にわたって信頼性が高いサービスだったことは指摘しておくべきだろう。またバージニア州北部データセンタ…続きを読む
Atlassian、ユーザーにウェブサービスのダウンタイムなどを通知するStatusPageを買収
Atlassianは本日StatusPageの買収を発表した。StatusPageはY-Combinatorのインキュベートから誕生し、オンラインでビジネスを行う企業が自社のオンラインサービスの状況をユーザーに知らせるサービスを提供している。買収額などの詳細は開示されていない。 昨年12月に上場して以降、Atlassianにとって初の買収案件となる。3年前にローンチしたStatusPageのようなサービスを追加することは、 Atlassianにとっては自然な流れだ。 Atlassianはこれまで長い間、全ての企業はソフトウェア企業であ…続きを読む
近日開催のイベント

